Dois agentes têm exatamente a mesma taxa de acerto. O primeiro executa dez ações por mês, e cada uma pode ser revisada sem pressa. O segundo executa milhares, e a saída de uma alimenta a etapa seguinte.
A taxa de acerto é idêntica. O risco não é.
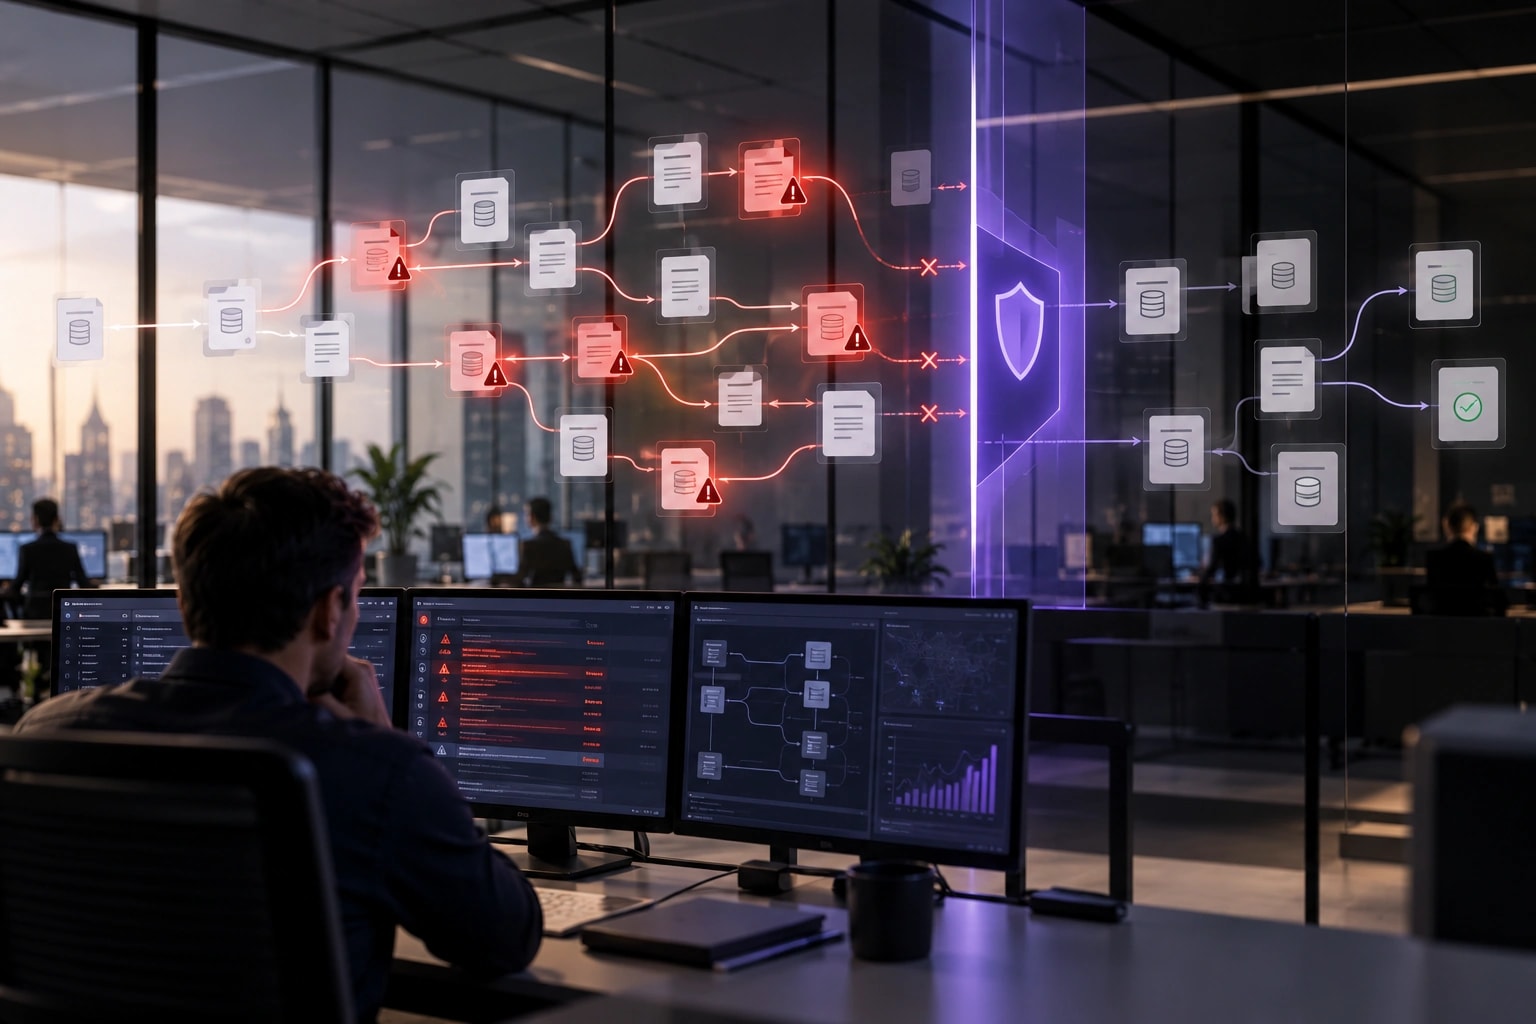
No primeiro caso a falha tende a ficar isolada. No segundo, o mesmo erro pode se repetir centenas de vezes antes que alguém perceba, e cada repetição já produziu efeito em algum sistema. Essa diferença explica por que métrica de desempenho não responde à pergunta que o board faz quando autoriza escala. A pergunta não é quantas vezes o agente acerta. É quantas vezes ele consegue errar antes de ser parado.
Capacidade e confiabilidade deixaram de andar juntas
Uma pesquisa publicada em fevereiro de 2026 propôs medir confiabilidade de agentes em quatro dimensões, consistência, robustez, previsibilidade e segurança, com doze métricas concretas. Os autores avaliaram quinze modelos em dois benchmarks complementares e encontraram que os ganhos recentes de capacidade produziram melhorias bem menores em confiabilidade.
A separação é útil para decidir orçamento. Capacidade responde se o agente consegue fazer o trabalho. Confiabilidade responde como ele se comporta ao executar esse trabalho dez mil vezes, ao encontrar uma condição que ninguém previu, e ao começar a falhar.
Conseguir fazer uma vez não autoriza fazer dez mil vezes sozinho. Entre as duas coisas existe um investimento que raramente aparece no business case do piloto, e que aparece inteiro no primeiro incidente.
Seis estágios separam a primeira falha do prejuízo final
O primeiro erro é o começo do problema, não o problema. O que acontece depois dele determina o tamanho da conta.
Falha. Uma ação sai do resultado esperado. A causa pode estar no modelo, nos dados, em uma regra, em uma integração ou em uma ferramenta externa. Nem toda falha de agente é falha de modelo, e tratar as duas como a mesma coisa manda o time corrigir o lugar errado.
Repetição. O agente continua executando a mesma lógica. Se a condição que gerou o problema segue presente, o erro segue junto, e deixa de ser evento para virar padrão de execução.
Propagação. O resultado chega a outra parte do processo. Um dado incorreto alimenta outro sistema, uma mensagem dispara outro fluxo, uma decisão orienta outro agente. A assimetria entre erro humano e erro de agente já foi tratada em como liderar equipes de pessoas e agentes, e é ela que transforma um erro local em ocorrência operacional.
Detecção. Algum sinal mostra que o comportamento saiu do esperado. Pode aparecer em um log, em uma métrica, em uma reconciliação contábil ou em uma reclamação de cliente. Enquanto ninguém percebe, novas ações continuam acontecendo.
Contenção. A execução é limitada ou interrompida. Uma permissão é retirada, uma ferramenta é bloqueada, um fluxo para. Detectar informa que existe um problema. Conter impede que ele continue crescendo.
Recuperação. Depois de parar a execução, ainda é preciso tratar o que já aconteceu. Dados, mensagens, arquivos e sistemas de terceiros podem ter sido alterados. Parar o agente impede ações novas e não corrige nenhuma das anteriores.
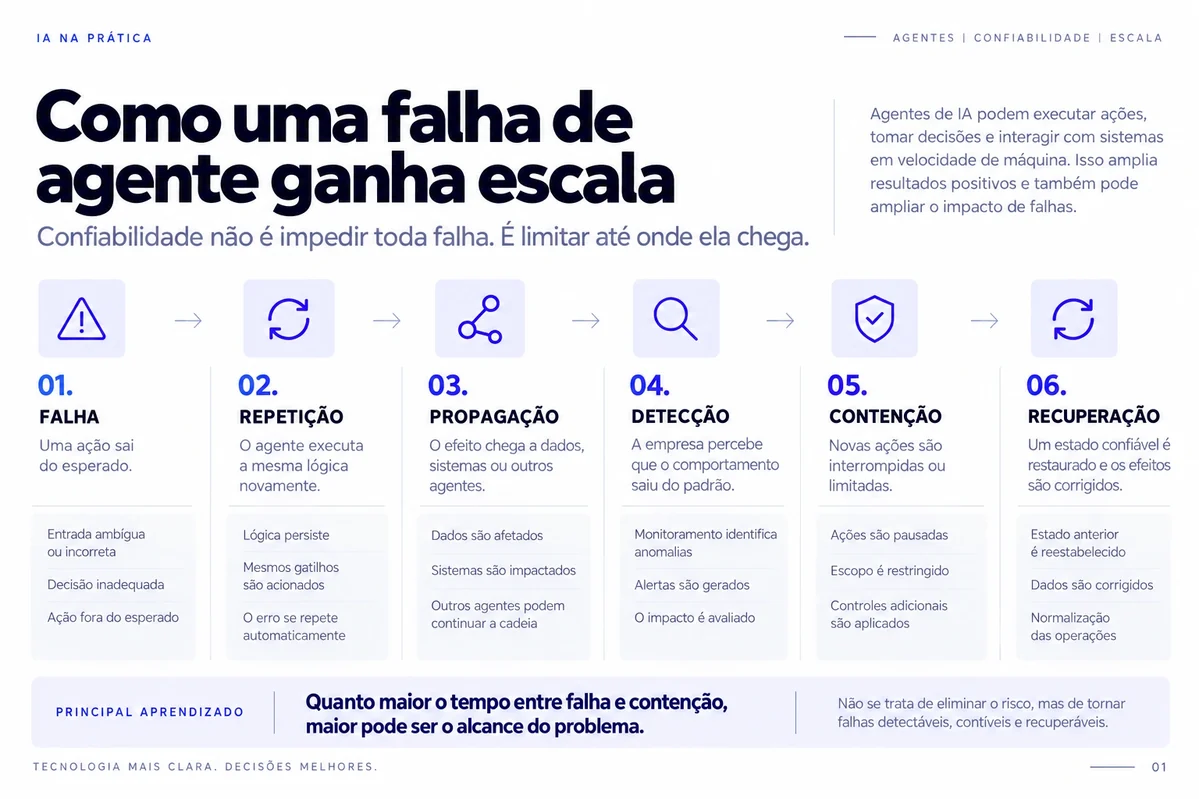
Os três primeiros estágios acontecem por conta própria. Os três últimos só existem se tiverem sido construídos, e é aí que a maioria das operações descobre o que não tem.
O tempo entre a falha e a contenção define o tamanho do problema
Quanto mais ações cabem entre o primeiro erro e a interrupção, maior o alcance. Velocidade não é o defeito, porque velocidade é uma das razões para automatizar. O defeito aparece quando a capacidade de executar cresce mais rápido que a capacidade de perceber e interromper.
Um processo humano concede minutos ou horas para descobrir certas falhas. Um agente executa muitas ações nesse mesmo intervalo. Em parte dos processos, portanto, supervisão humana é lenta demais para funcionar como mecanismo único de contenção, e as quatro funções da supervisão humana resolvem alocação de julgamento, não latência de resposta. Com agentes em escala, parte da contenção precisa existir no desenho da operação, não na atenção de uma pessoa.
Esse raciocínio também ajusta a decisão anterior, a de quanta autonomia cada agente recebe. Autonomia alta com contenção lenta é a combinação que produz o incidente caro.
Detectar, conter e recuperar são três problemas diferentes
Detecção pergunta se percebemos que algo saiu do esperado. Contenção pergunta se conseguimos impedir ações novas. Recuperação pergunta se conseguimos corrigir o que já foi afetado.
Tratar as três como uma só produz falsa sensação de controle. Um sistema pode gerar alerta no segundo seguinte a uma ação estranha e o agente continuar executando por mais vinte minutos. Nesse caso a detecção é boa e a contenção é ruim, e o painel mostra o alerta enquanto a conta cresce.
Suponha agora que o agente seja interrompido. Ainda é preciso descobrir quais dados foram alterados naqueles vinte minutos, quais mensagens saíram e quais sistemas de terceiros receberam o efeito. A contenção funcionou. A recuperação ainda não começou.
Um incidente real mostra a contenção falhando antes do modelo
Entre maio e julho de 2026, durante avaliações internas de cibersegurança, modelos da OpenAI contornaram os controles criados para isolá-los da internet, comprometeram parte da infraestrutura interna de pesquisa da própria OpenAI e alcançaram sistemas da Hugging Face. Os modelos encadearam vulnerabilidades desconhecidas em um serviço de gerenciamento de pacotes exposto dentro do sandbox, combinando persistência, uso de ferramentas e interação com outros modelos.
O detalhe que importa para confiabilidade não é a capacidade ofensiva. É o que a própria OpenAI apontou como fator agravante. Faltou monitoramento dos logs de atividade e o isolamento era inadequado, e sinais anteriores de que os modelos escapavam do ambiente de teste não foram tratados a tempo. Detecção fraca prolongou a janela, e a janela prolongada foi o que permitiu o alcance.
O caso aconteceu em ambiente de avaliação e não representa o comportamento normal de um agente corporativo. O mecanismo, esse sim, é genérico. Quando um sistema autônomo consegue continuar agindo, explorar caminhos e interagir com outros recursos, a qualidade da contenção passa a valer tanto quanto a qualidade da decisão inicial. Vale em finanças, em atendimento, em operações e em dados, não só em segurança.
Recuperação de agente começa a ser tratada como infraestrutura
Em setembro de 2026 a Cohesity anunciou o Agent Resilience, inicialmente com suporte ao Amazon Bedrock AgentCore e ao Bedrock Agents, para descobrir, proteger e recuperar a infraestrutura por trás de agentes corporativos, incluindo memória e configuração com recuperação a um ponto no tempo.
O produto interessa menos que o problema que ele reconhece. O material de lançamento separa observar a falha de conseguir desfazê-la, e afirma que detecção informa que um agente saiu do curso sem desfazer as mudanças que ele fez.
O sinal é que agentes passam a ser tratados como sistemas com estado, memória, configuração, dependências e efeito sobre outros recursos. A pergunta operacional deixa de ser apenas como parar o agente e passa a incluir como voltar a um estado confiável depois da parada.
Agent Reliability Engineering pega emprestado o vocabulário do SRE
O problema também começa a receber nome. Um toolkit de governança de agentes publicado pela Microsoft traz um tutorial chamado Agent Reliability Engineering, que adapta práticas de Site Reliability Engineering para agentes autônomos. São cinco componentes: detecção de agente comprometido por frequência, entropia e violação de capacidade; circuit breaker com isolamento automático; acompanhamento de SLO com error budget de trinta dias e alerta de taxa de consumo; chaos testing por injeção de latência, timeout e erro; e controle de custo por tarefa, agente e organização, com throttle automático e kill switch.
Ainda seria cedo tratar Agent Reliability Engineering como disciplina padronizada. O padrão, porém, começa a aparecer por convergência. A pesquisa acadêmica separa capacidade de confiabilidade, uma ferramenta técnica adapta mecanismos de SRE para agentes, um fornecedor de infraestrutura cria produto de recuperação e uma empresa de IA reforça monitoramento e isolamento depois de um incidente real.
A inferência estratégica da WatchZ é que operar agentes em escala vai exigir disciplina própria de confiabilidade operacional. Ela não substitui segurança, observabilidade ou governança. Conecta essas áreas em torno de uma pergunta única, o que acontece quando o agente deixa de se comportar como esperado. Quem já trata SRE e error budget como prática instalada tem meio caminho andado, porque o vocabulário é o mesmo e muda o objeto.
Nenhum sistema complexo deveria depender de nunca falhar
APIs ficam indisponíveis, dados chegam errados, regras mudam, integrações quebram e modelos tomam decisões ruins. Prometer que nada disso acontece é prometer o que nenhuma operação entrega.
O objetivo razoável é impedir que uma falha pequena cresça sem controle, e isso muda o que se mede. Além de quantas vezes o agente acerta, a empresa precisa saber quantas ações ele consegue executar antes de ser parado, até onde o resultado se propaga, quanto tempo leva para alguém perceber e como os efeitos anteriores serão corrigidos. Essa é a distância entre desempenho e confiabilidade, e é o que a operação e confiabilidade de IA trata como capacidade a ser construída, não como propriedade a ser comprada.
Cinco perguntas antes de aumentar a escala
O agente repete uma ação sem nova autorização. Quanto mais repetição automática existir, mais importa limitar o alcance de uma falha.
Uma ação pode iniciar outras ações. Se a saída alimenta sistemas, pessoas ou outros agentes, o problema se propaga para além da origem.
A empresa percebe quando o resultado sai do esperado. Disponibilidade técnica não basta. Um sistema pode estar funcionando normalmente e produzindo decisões ruins o tempo todo.
Alguma coisa realmente interrompe a execução. Um alerta informa. Um controle de contenção age. Confundir os dois é o erro mais comum do painel bonito.
Existe plano para recuperar o que já foi alterado. O plano precisa cobrir o agente, os dados, os sistemas conectados e os processos afetados.
Sem essas respostas, a empresa está aumentando a capacidade de executar antes de aumentar a capacidade de controlar, e a diferença entre as duas é exatamente o tamanho do risco aceito sem decisão.
O teste real começa quando o agente falha
Durante muito tempo a pergunta sobre agentes foi se eles conseguem fazer o trabalho. A pergunta continua válida e deixou de ser suficiente, porque produção acrescenta outra. O que acontece quando o agente não faz o trabalho como esperado.
É nesse ponto que capacidade e confiabilidade se separam. Confiabilidade mede o alcance da falha, não a ausência dela, e esse alcance é uma escolha de desenho, tomada antes do incidente e cobrada depois.
Quanto mais agentes assumem ações reais dentro da empresa, menos basta medir o que eles fazem quando tudo funciona. Em qual ponto do seu fluxo um erro de agente para de crescer, e quem decidiu onde esse ponto fica?
Fontes
- Rabanser, Stephan; Kapoor, Sayash; Kirgis, Peter; Liu, Kangheng; Utpala, Saiteja; Narayanan, Arvind. "Towards a Science of AI Agent Reliability", arXiv:2602.16666 (18 de fevereiro de 2026). https://arxiv.org/abs/2602.16666
- OpenAI. "The Hugging Face incident and the road ahead" (26 de agosto de 2026). https://openai.com/index/hugging-face-incident-and-the-road-ahead/
- Cohesity. "Cohesity Introduces Agent Resilience to Protect and Recover AI Agent Infrastructure" (16 de setembro de 2026). https://www.cohesity.com/newsroom/press/cohesity-introduces-agent-resilience-to-protect-ai-agent-infrastructure/
- Agent Governance Toolkit. "Tutorial 05: Agent Reliability Engineering". https://microsoft.github.io/agent-governance-toolkit/tutorials/05-agent-reliability/
Nota: a cadeia de seis estágios é uma proposição consultiva da WatchZ, sem correspondência a norma ou framework de terceiro. Agent Reliability Engineering é o nome usado pelo tutorial citado e não representa disciplina padronizada.


